牛顿棋RL 2:先手孱弱的偏科生
首先,看我的图文帖子,已经把 demo 上线到了网站上 https://spdc-elm.github.io/newton-chess-RL ,大家都可以体验一下跟我的 AI 对弈的感受。目前有四个版本的模型。
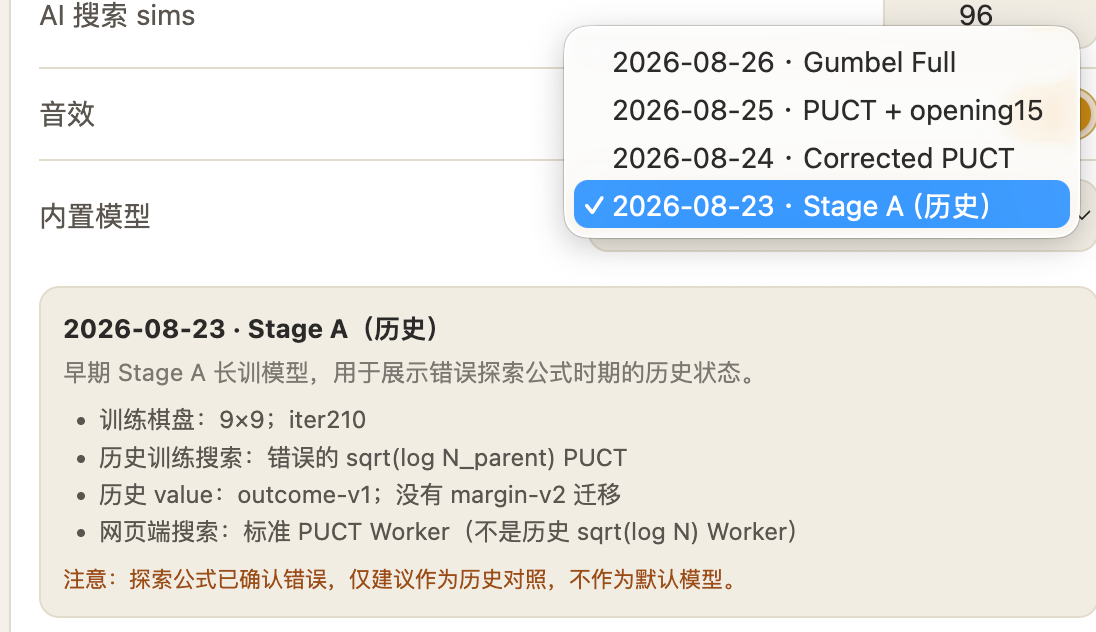
其中呢,上篇文章训出来的就是 8-23 这个版本的了。实际体验下来,只能说…相当稚嫩,比如下图…上来就先给对手送分(还是说,这真是好策略?是我太菜了吗?)。但是鄙人还是能够下赢这个版本的 AI 的。210 个 iteration ,还是不够吗?这么蠢吗?

210 iterations × 240 games/iteration = 50,400 盘,虽然我知道 AI 学得比人慢点,但不至于这么慢吧。我于是让 AI 排查是否是训练哪里出了问题。
ox-alpha (已经被 GLM-5.3-flash 认领了)写错了 PUCT 公式
结果,还真是 ox-alpha 写 PUCT 的时候, 它写成了 ,其实是搞混了经典 MCTS 的 UCT(那个就有个 ln 项)… 所以啊,弱一点的AI 还是会有粗心错误的时候。
这个错误有啥影响呢?以 (N(s)=96) 为例: 而 , 探索项的分子小了约:
回顾一下 PUCT 的公式,
其中:
- :父节点 总共被搜索了多少次,近似为
- :从 选择动作 的次数
- :目前搜索估计的动作价值
- :网络 policy prior
父节点被搜索得越多,说明我们在这个局面上投入的总搜索预算越大。这一项其实是为了避免某个局面下,我们的探索计算偏心向特定的一个下法(s,a)
比如,局面 s 下一个还没有访问过的动作:
它的探索奖励约为:
随着父节点总访问次数增加,这个未充分探索的动作的奖励会变大,迫使搜索迟早去检查它。
而该局面 s 下已经被访问很多次的动作 a 则因为 大,,分母会压低它的探索奖励。
一言以蔽之,对于一个探索得比较多的 state,这一个公式的设计会平衡它的多个可能下一步的探索,从而避免因为一开始的偏差而过分地探索某一步a,漏过了其它步骤。
而这个根号的设计想必是当时论文设计者们摸索出来的一个比较合适的曲线吧。然而 AI 写多了个 ln,让父局面 s 探索次数的影响大大减小了,从而更容易因为一开始的探索偏差而过分地探索某一步a。探索偏差是哪来呢?一般就是 policy 一开始给出的预测偏好,还有 Q (可能是前期探索运气好,遇到的局面 value 比较高)等等导致的。
因为 AI 网络一开始不大聪明,所以这个偏好其实是有害的,相当于网络的探索冲动被压制了,比较保守,固守自己的经验…于是乎,训练就比较缓慢了。
修正之后…
把 PUCT 公式修正之后,我没有选择从之前那个烂模型的参数启动,而是从 0 开始重置了 AI 的大脑,用随机参数再次启动了训练。又是210 个 iter 之后…我们得到了 8-24 版本的模型。
那咋评价呢?当然是让这两个版本的模型互相对战一下啦。
| 模型 | 胜 | 平 | 负 | 总局数 |
|---|---|---|---|---|
| A:8-23 Stage A@210 | 73 | 21 | 306 | 400 |
| B:8-24 Corrected PUCT@210 | 306 | 21 | 73 | 400 |
比较碾压了,果然有进步。再看看先后手的情况:
| 先手方 | 先手模型 | 先手模型胜 | 和 | 先手模型负 |
|---|---|---|---|---|
| A 先手,B 后手 | A | 14 | 9 | 177 |
| B 先手,A 后手 | B | 129 | 12 | 59 |
诶,我们发现一个事情:虽然 B 依然碾压了 A,但是在先手的时候,优势没有那么大了。那我们再仔细看看模型自己跟自己打的时候,先后手的胜率差异呢?
| 自战模型 | 先手胜 | 和棋 | 后手胜 | 总局数 |
|---|---|---|---|---|
| A:Stage A@210 | 6 | 5 | 189 | 200 |
| B:Corrected PUCT@210 | 1 | 0 | 199 | 200 |
哟,不看不知道,一看吓一跳,全是偏科生。甚至,PUCT 正确的这个模型训出来更加偏科。这里就有两种可能了:
- 牛顿棋本身先后手非常不均衡,后手几乎必胜,先手的时候模型已经尽力了
- 模型训歪了,失衡了
我试着跟 8-24 的 AI 对弈了几局(你们也可以去网站试试),开着 96sims,当我是先手的时候,我觉得 AI 下后手没什么毛病,每一步都挺合理,甚至有些我想不到的妙手。


这是全盘的代码,大家可以拿去我的网站,点击导入,在棋谱区域点按钮,重放欣赏一下 AI 后手的每一步,其实感觉挺有水平的。
nf1.9.9.2.b.443344334344343343445435344333473532222343113344242333222335344232337444432413344332144423462415252436445754654566534464636226.rgs4ue
但是再看先手,就是另一番景象了:

我还以为是我 sims 开小了,于是把 sims 拉到了 500,但是 AI 依旧下这,让人摸不着头脑。如果不是之前看了它自我对弈的数据,先手如此惨败,我还以为它是学出了什么惊为天人的妙手呢。

没话说,确实看不懂,也确实菜,我随便都能打赢,大家可以自行去体验一下 8-24 的模型先手有多蠢。而至少我用先手跟模型下的时候,并不会那么大比分被碾压的输掉。所以我的判断是,牛顿棋可能本身确实后手有优势,但是并不至于这么离谱。 目前 AI 的先手水平远远不是这个棋类本身先手的上限。
于是我开始(鞭策 AI)分析为何会有这样的情况…终于,我又找到了一个在 牛顿棋RL 1:强化学习靠左脚踩右脚,真的可以上天? 设计时埋下的雷…(未完待续)